NVIDIA lança DGX Spark com 64 GB de memória unificada para rodar modelos até 100 bilhões localmente
NVIDIA lança DGX Spark 64GB com memória unificada para executar modelos até 100B localmente; clustering expande para 200B e suporte a frameworks populares.
 Riccardo Neri
RESUMO ✦
Sem tempo? A Lili IA resume para você
NVIDIA lança DGX Spark com 64 GB de memória unificada para rodar modelos até 100 bilhões localmente
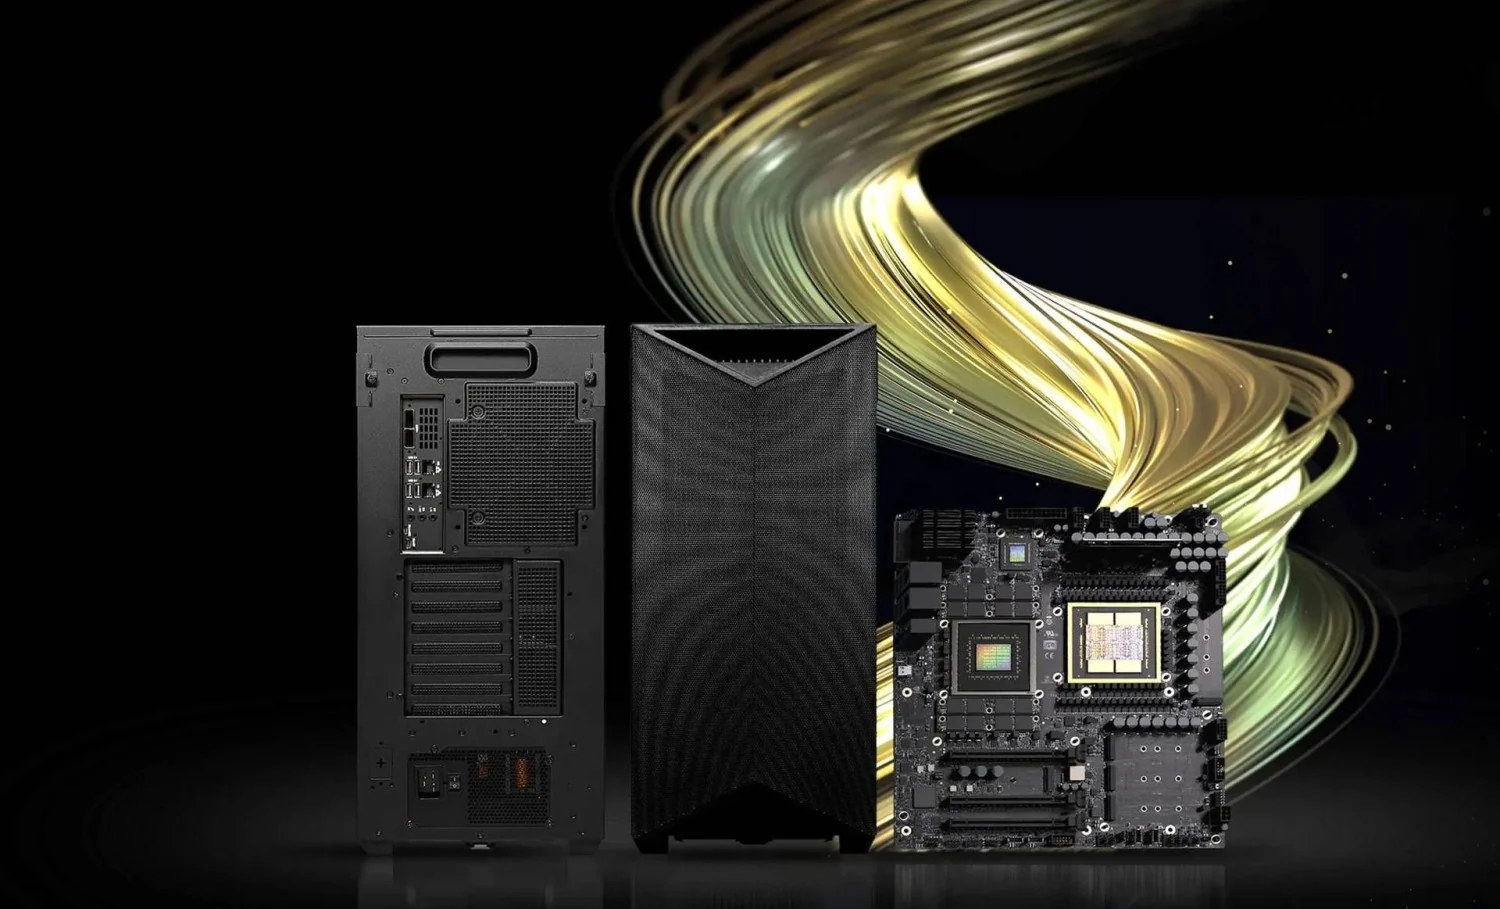
Por Riccardo Neri — Em uma evolução que desloca parte da inteligência fora da nuvem e para o perímetro local, a NVIDIA anunciou a versão com 64 GB de memória unificada do supercomputador compacto DGX Spark. A mudança é projetada para oferecer a desenvolvedores, pesquisadores e analistas de dados um ponto de acesso de hardware dedicado para execução de agentes de IA, inferência e fine-tuning sem depender sempre de provedores cloud externos.
 Guia Itália +
Tradução Juramentada e Assessoria Documental na Itália
A **Pietra Global Assist** oferece assessoria documental personalizada para brasileiros e estrangeiros na Itália, com atendimento em português e acompanhamento em t…
Arquiteturalmente, o equipamento mantém o mesmo alicerce técnico do modelo de 128 GB: o superchip GB10 Grace Blackwell, o sistema operacional DGX OS e todo o stack de software CUDA-X. Essa coesão de pilha permite que modelos com até 100 bilhões de parâmetros sejam executados diretamente no dispositivo, reduzindo latências e custos associados ao tráfego constante de dados para a nuvem — é uma redistribuição do fluxo de dados mais do que uma simples atualização de memória.
No capítulo de conectividade e escalabilidade, o DGX Spark com 64 GB inclui uma placa de rede ConnectX-7. Usando a ferramenta NVIDIA Sync Cluster Assistant, duas unidades podem ser acopladas via cabo QSFP para agregar recursos: soma-se uma memória total de 128 GB e o suporte a modelos de até 200 bilhões de parâmetros. Em testes internos com o modelo Qwen 3.8 27B, a configuração em cluster de dois nós mostrou ganho de desempenho de até 1,7x frente ao sistema único e duplicou a banda de memória disponível — resultados que ilustram bem como a interligação de nós age como uma lombada de alta capacidade no sistema nervoso das infraestruturas de IA.
A plataforma traz suporte nativo para frameworks e bibliotecas de inferência amplamente utilizadas, incluindo Ollama, vLLM, PyTorch e o NVIDIA Agent Toolkit. Está em distribuição um instalador dedicado para o Blender, voltado a aplicações gráficas, e o pacote inclui o NVIDIA Sync Model Launcher, pensado para facilitar download e gestão de modelos locais, além de integrar o ambiente de programação OpenCode diretamente via navegador.
Do ponto de vista operacional, a oferta representa uma opção pragmática: em vez de transferir cargas sensíveis ou de baixa latência para centros de dados distantes, empresas e instituições podem posicionar esses nós localmente — próximos aos dados e aos usuários — e reconstruir camadas de inteligência onde faz mais sentido em termos de eficiência e privacidade. A analogia é direta: mover o algoritmo para perto da fonte é como instalar um transformador adicional na malha elétrica para reduzir perdas e melhorar a resiliência.
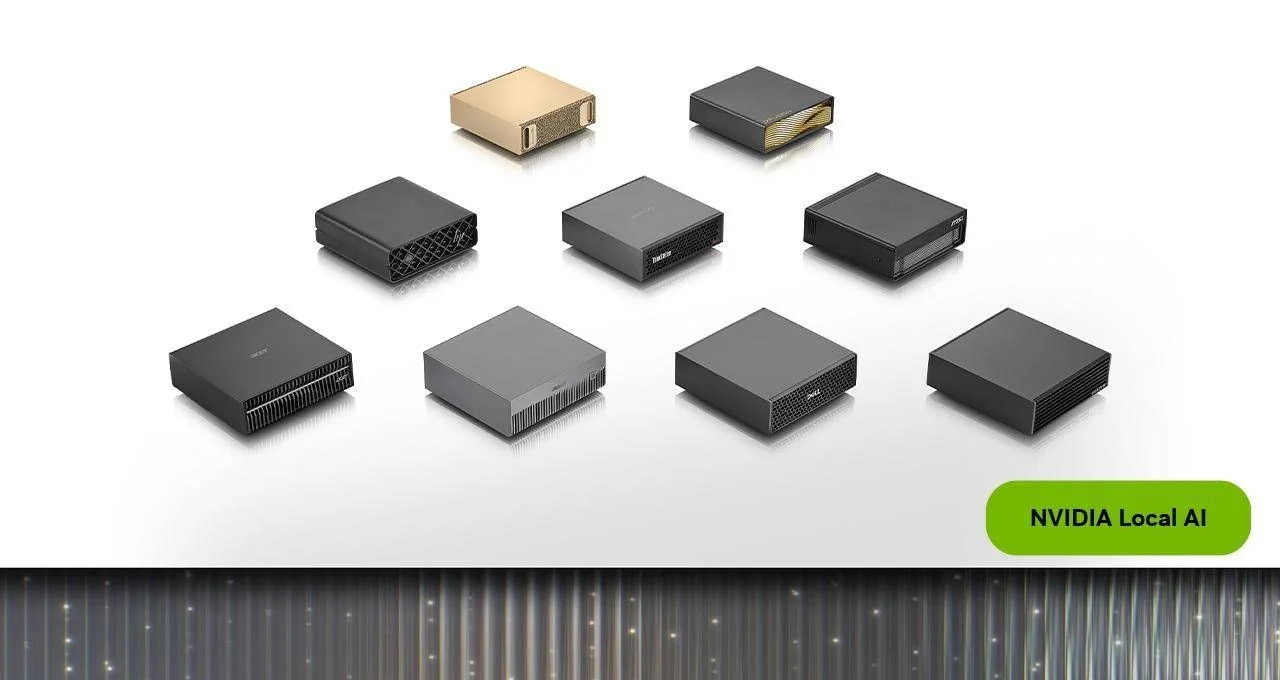
A disponibilidade comercial da configuração de 64 GB do DGX Spark foi marcada para 23 de outubro de 2026, com distribuição por parceiros OEM como Acer, ASUS, Dell, Gigabyte, HP e MSI, e um preço inicial anunciado em US$ 4.999 (listagens regionais serão formalizadas pelos distribuidores locais).
Em resumo, a proposta da NVIDIA consolida a tendência de arquiteturas híbridas: camadas de processamento local robustas e interoperáveis com a nuvem, oferecendo mais autonomia no desenvolvimento e na operação de modelos de grande escala — uma peça a mais nos alicerces digitais que sustentam as cidades e infraestruturas inteligentes do futuro próximo.
 Guia Itália +
Especialista em Direito do Trabalho e Direito Civil
Advogada Elena Musarella Especialista em Direito do Trabalho e Direito Civil Sou a advogada Elena Musarella e construí minha trajetória profissional com uma formaçã…